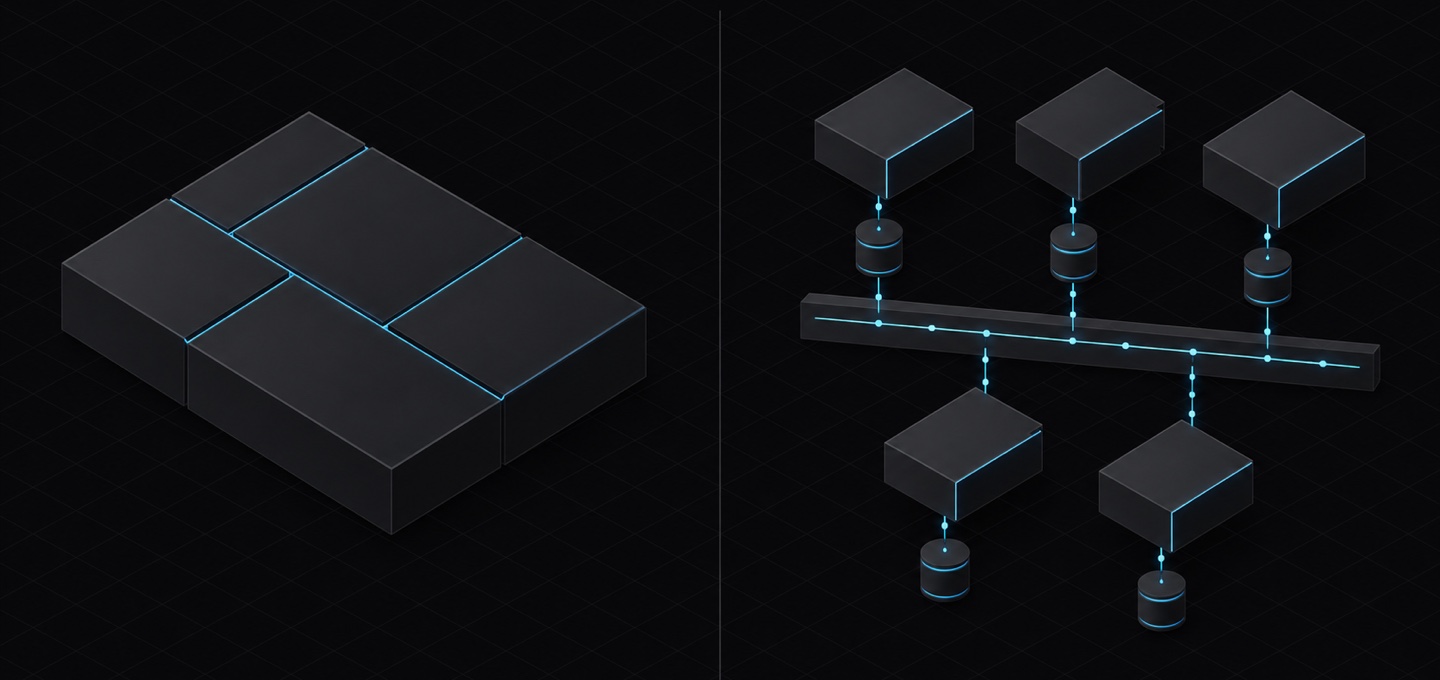
Hoje eu trabalho com os dois estilos de arquitetura ao mesmo tempo. Uma plataforma de delivery, que aqui vou chamar de Alfa, tem mais de dez serviços NestJS. Uma plataforma de jogos, a Beta, tem serviços por domínio num monorepo. E uma comunidade de poker, a Gama, tem mais de dez microsserviços. Ao mesmo tempo, mantenho vários monólitos modulares, e este portfólio é um deles: uma API NestJS com 14 módulos e um deploy só. Uso ele como exemplo porque é o que eu posso mostrar por dentro. Ver os dois lado a lado mudou a pergunta que eu faço. Não é "qual é melhor", e sim "qual custo eu quero pagar agora".
flowchart LR
  subgraph mono["Monólito modular: um processo, um deploy"]
    direction TB
    proj["módulo de projetos"]
    art["módulo de artigos"]
    agent["módulo do agente de conteúdo"]
    agent -->|chamada em memória| proj
    agent -->|chamada em memória| art
    subgraph pg["PostgreSQL, ou um banco por módulo"]
      dbp[("dados de projetos")]
      dba[("dados de artigos")]
    end
    proj --> dbp
    art --> dba
  end
  subgraph micro["Microsserviços: um deploy por serviço"]
    direction TB
    checkout["serviço de pedidos"]
    mq["RabbitMQ"]
    pay["serviço de pagamentos"]
    notif["serviço de notificações"]
    checkout -->|mensagem| mq
    mq --> pay
    mq --> notif
    d1[("banco de pedidos")]
    d2[("banco de pagamentos")]
    checkout --> d1
    pay --> d2
  end
O que cada um é, sem rodeio
- Monólito modular: um deploy, com o código dividido em módulos por domínio e fronteiras explícitas entre eles. Os módulos se chamam em memória, e cada um é dono dos próprios dados: as tabelas podem ficar num banco compartilhado, num schema por módulo ou num banco por módulo, conforme a necessidade.
- Microsserviços: cada domínio vira um serviço com o próprio deploy e, de preferência, o próprio banco. A conversa entre eles passa pela rede, por HTTP ou por mensageria.
A diferença que pesa não é o tamanho do código, é onde fica a fronteira. No monólito modular, ela é uma regra de código. Nos microsserviços, ela é a rede. E monólito modular não quer dizer que não escala: o mesmo processo roda em várias réplicas atrás de um balanceador, e um módulo que cresce pode ganhar o próprio banco sem virar serviço.
O que os microsserviços me deram
- Deploy, dados e falha isolados: na Alfa, cada serviço tem a própria imagem de contêiner e, em produção, o próprio PostgreSQL, e é implantado separadamente. Mexer no emissor fiscal não exige publicar o serviço de pedidos. No ambiente local, um único PostgreSQL atende todos, o que deixa o desenvolvimento leve.
- Escala por parte: na Beta, os serviços de casino e de gaming podem rodar em dois papéis, web e worker. O worker roda crons e filas sem abrir porta HTTP, e cada papel escala do seu jeito.
- Fronteiras que ninguém atravessa sem querer: com um banco por serviço, um domínio não lê a tabela do outro por atalho. O contrato é a mensagem.
- Times independentes: num produto com mais gente, como a Gama, cada serviço tem um dono claro e evolui no próprio ritmo.
O que eles me cobraram
Tudo o que antes era uma chamada de função vira um problema de sistema distribuído.
- Mensageria tem armadilhas: na Gama, uma única fila de transações era consumida por quatro serviços. O RabbitMQ entrega em rodízio, sem olhar o tipo da mensagem, então confirmações de pagamento caíam no serviço errado e eram descartadas em silêncio. A correção foi uma fila por serviço.
- Consistência eventual e idempotência: na Beta, o mesmo depósito pode chegar duas vezes, por reenvio do provedor ou da fila. Cada crédito leva uma chave única, e um reenvio devolve o recibo original. Num monólito, boa parte disso seria uma transação.
- Jobs em várias réplicas: crons rodando em mais de uma instância precisam de coordenação. Na Beta, isso é um lease no Redis por marca, serviço e job.
- Observabilidade deixa de ser opcional: com mais de dez serviços, a pergunta "por que esse cadastro demorou?" só tem resposta com trace distribuído. Na Gama, eu montei OpenTelemetry nos serviços e no navegador para isso.
- Mais coisa para operar: broker, coletor de telemetria, dezenas de contêineres e pipelines. Cada peça é um ponto a mais para monitorar, atualizar e entender quando dá errado.
O monólito modular deste portfólio
Para o portfólio, eu escolhi o caminho oposto, de propósito. É um domínio pequeno, mantido por uma pessoa, e o que eu mais quero aqui é simplicidade para operar.
- Um módulo por domínio: projetos, artigos, estudos de caso, tecnologias, mídia, autenticação, analytics e o agente de conteúdo, cada um com controller, service, DTOs e as próprias consultas no Prisma.
- Dados por módulo: hoje os módulos dividem um PostgreSQL porque o volume cabe nele, e cada um trabalha com as próprias tabelas. Se um módulo precisar, ele ganha um schema ou um banco só dele, sem virar serviço.
- Fronteira pelo serviço: quando o agente de conteúdo transforma um rascunho em projeto ou artigo, ele chama os serviços desses módulos, em vez de montar os registros por conta própria.
- Uma exceção consciente: na publicação, o agente atualiza as traduções de projetos, artigos e estudos de caso na mesma transação SERIALIZABLE que grava o job. É o único ponto em que um módulo escreve nas tabelas de outro, e eu aceitei isso pela atomicidade. É exatamente o acoplamento que eu teria que redesenhar, com uma saga ou um outbox, se esses módulos virassem serviços.
- Um deploy só: a imagem da API aplica as migrations ao subir, e um push na main publica tudo.
- Regras que protegem as fronteiras: nada de barrel exports internos, imports sempre direto do arquivo e uma camada de abstração só quando a regra de negócio justifica.
O risco do monólito modular é a fronteira apodrecer, porque nada impede um import errado. A defesa é disciplina e revisão de código, não a rede.
Lado a lado
- Deploy: um só, contra um por serviço.
- Dados: cada módulo é dono dos seus dados, num banco compartilhado ou num banco por módulo, com transações entre módulos enquanto os dados estão juntos, contra um banco por serviço, com consistência eventual.
- Falhas: um bug grave pode derrubar o processo inteiro, contra uma falha contida no serviço, desde que as chamadas tenham timeout e um plano B.
- Escala: réplicas da aplicação inteira, contra cada parte escalando sozinha.
- Depuração: stack trace local, contra trace distribuído e logs correlacionados.
- Operação: custo baixo, contra um custo alto que cresce com o número de serviços.
- Fronteiras: mantidas por regra de código, contra impostas pela rede.
E se a Alfa fosse um monólito modular?
Fiz esse exercício com a Alfa, que é a arquitetura de que eu mais gosto entre as que mantenho. Ela viraria uma API NestJS com os mesmos domínios como módulos: auth, catalog, commerce, payment, subscription, affiliates, procurement, scheduling e communication, com o mesmo código rodando também no papel de worker para as filas Bull.
- O que mudaria: o checkout pediria o link de pagamento direto ao módulo de pagamentos, sem ida e volta pela fila, e o fluxo de pedido pago, cupom na impressão e aviso ao cliente caberia numa transação local com um outbox. Os dados ficariam num PostgreSQL com um schema por módulo.
- O que eu manteria fora: o emissor fiscal continuaria um serviço à parte: ele tem certificado digital, regra fiscal própria e depende da SEFAZ, e uma SEFAZ lenta não pode segurar o checkout. O gateway de WhatsApp já é um sistema de terceiros e seguiria separado.
- O que eu perderia: um pico de webhooks de pagamento escalaria a aplicação inteira, um bug grave num módulo derrubaria o processo de todos, e uma correção no catálogo publicaria junto o código de pagamento.
O exercício confirmou a escolha. A Alfa tem dinheiro, nota fiscal e tempo real no mesmo fluxo, e cada serviço com o próprio deploy e o próprio PostgreSQL em produção é o que mantém um problema numa parte longe das outras. Ali, o custo dos microsserviços se paga.
O que a indústria tem contado
Não sou o único a chegar nessa conclusão. Martin Fowler defende começar pelo monólito e extrair serviços só quando as fronteiras estiverem claras, porque os microsserviços cobram um custo extra que só compensa em sistemas complexos o bastante. A Shopify escolheu organizar o próprio monólito em módulos, em vez de quebrá-lo em serviços. A Segment juntou mais de uma centena de serviços em um só, depois de anos pagando o custo de operá-los. E o time do Prime Video levou um fluxo de monitoramento distribuído para um único processo e reduziu o custo de infraestrutura em mais de 90%.
Como eu decido hoje
Começo por um monólito modular, com fronteiras de domínio bem desenhadas, e só extraio um serviço quando aparece um destes sinais:
- uma parte precisa escalar de um jeito muito diferente das outras;
- uma falha nessa parte não pode derrubar o resto, como num fluxo de dinheiro;
- um time precisa publicar sem coordenar com os outros;
- a parte tem exigências próprias de segurança, conformidade ou tecnologia.
Se nenhum desses sinais aparece, um serviço novo é só latência, consistência eventual e mais uma coisa para operar. E, quando aparece, um módulo com fronteira limpa vira serviço com muito menos dor do que um monólito emaranhado.